Como escalar um motor de licitações B2G mantendo a eficiência da infraestrutura na AWS e garantindo velocidade.
Quando se constrói uma plataforma projetada para processar centenas de milhares de editais, realizar OCR de milhões de páginas e executar chamadas contínuas de IA em tempo real, o desafio deixa de ser apenas a codificação e passa a ser a gestão financeira da infraestrutura.
O maior “assassino” oculto de startups de tecnologia, especialmente as que operam modelos pesados de Inteligência Artificial, é a conta da cloud no fim do mês.
Para que o Lance Certo consiga oferecer aos seus clientes PMEs um SaaS com preços acessíveis, os bastidores da nossa operação exigiram uma arquitetura “AWS-First” fanaticamente otimizada para performance e custo, garantindo que o processamento massivo de dados não destruísse a margem de operação.
A Guerra Contra a Latência e os Custos
No mercado de licitações em tempo real, a latência não é apenas um incômodo; é o motivo pelo qual se perde um contrato. O motor de lances precisa reagir em frações de segundo. Se o servidor estiver sobrecarregado por processos em segundo plano, o seu concorrente leva o pregão.
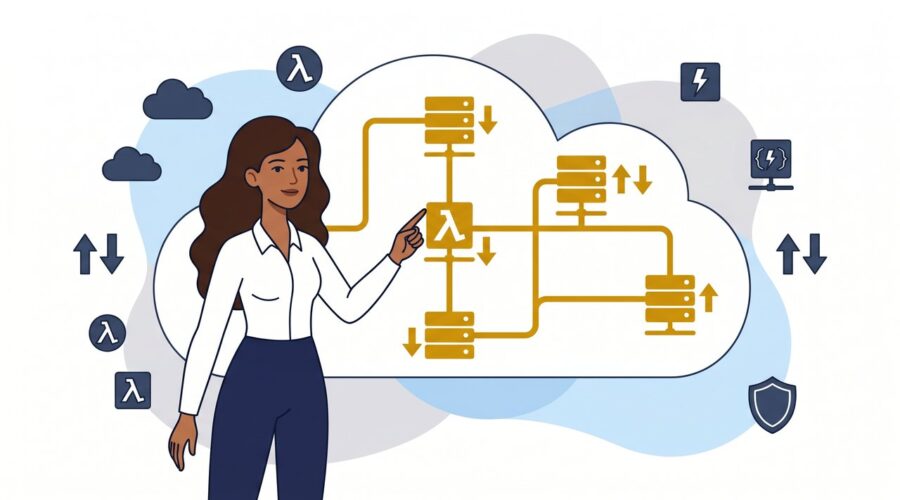
Para solucionar isso, abandonamos a ideia de servidores monolíticos ligados 24/7. A nossa arquitetura assenta numa espinha dorsal inteiramente Serverless (AWS Lambda). Isso significa que só pagamos pelo milissegundo de processamento exato quando o robô precisa enviar um lance ou quando o usuário acessa um edital, reduzindo os custos ociosos a quase zero.
- AWS Lambda: Execução do Motor de Lances em tempo real (pagamento por milissegundo).
- Amazon Textract: Extração inteligente e econômica de dados em PDFs pesados e digitalizados.
- Amazon Bedrock: Orquestração nativa de Modelos Claude, sem a latência de APIs externas de terceiros.
- Compressão AQT: Algoritmos internos para comprimir os dados dos editais antes de enviá-los ao banco de dados, poupando armazenamento no S3.
O “Cérebro” Integrado na Nuvem
Um dos nossos maiores saltos de otimização foi a centralização do processamento de Inteligência Artificial no Amazon Bedrock. Em vez de cruzar a internet com chamadas lentas para serviços de IA espalhados pelo mundo, mantemos tudo dentro do mesmo ecossistema virtual privado (VPC).
Quando o sistema coleta um edital do Compras.gov.br, ele vai direto para o Amazon Textract. O texto limpo flui para a análise do modelo Claude Opus no Bedrock e a decisão é armazenada na nossa base de dados Amazon RDS (PostgreSQL multi-tenant) de forma isolada e hiper-segura por CNPJ. Tudo isso acontece com latências de rede inferiores a 5 milissegundos.
No mercado de tecnologia B2G, a latência de infraestrutura é a diferença técnica exata entre vencer ou perder um lance eletrônico.
Escalabilidade Inteligente: Pague Só pelo que Usa
O resultado prático de semanas de engenharia de DevOps e otimização é uma plataforma que se adapta à agressividade do mercado.
Se 50 prefeituras publicarem grandes editais simultaneamente numa segunda-feira de manhã, a nossa infraestrutura expande os recursos na AWS de forma elástica, processa tudo e depois contrai automaticamente.
Esta eficiência garante que a sua empresa não pague pelos horários de pico. Você paga um valor fixo, mensal e previsível, e o nosso departamento de engenharia garante que, independentemente do tamanho do edital ou da disputa, o sistema será rápido e implacável.
A otimização de infraestrutura não é um diferencial tecnológico que fica nos bastidores. É ela que determina diretamente o preço que você paga pelo SaaS e a velocidade com que os lances chegam ao portal antes dos seus concorrentes. No mercado de pregão eletrônico, milissegundos são vantagem competitiva real.